泰国文档上的字段,按类型为您填好
新账户的免费积分最多可读取 7 页,无需绑卡。
一张税务发票进来,十三位号码、三个日期和一个文字书写的合计金额,都要落进正确的列。字段命名一次,此后每一份文档都会把它们填好。
- 格式
- PDF、PNG、JPEG、WebP
- 每次请求
- 一份文档,最多 20 页
- 每个 schema
- 最多 100 个叶字段
- 模型
- paxa-doc-extract-v1
读取只是工作中较小的一半
较大的一半,是判断每个数字是什么。哪个是卖方的税号,哪个是买方的。哪个日期是开具日期。文字金额与合计是否相符。这是人拿着荧光笔做的工作,也是业务量一大就最先跟不上的工作。
Paxa Document Extraction 接收您编写的 schema,也就是一组有名称、各有类型的字段,然后按页面内容把它填好返回。每个值都是印在那里的文字,按其类型读取。页面上没有对应的值时,该字段为 null,响应会说明原因。系统不做估算,也不去别处查找。
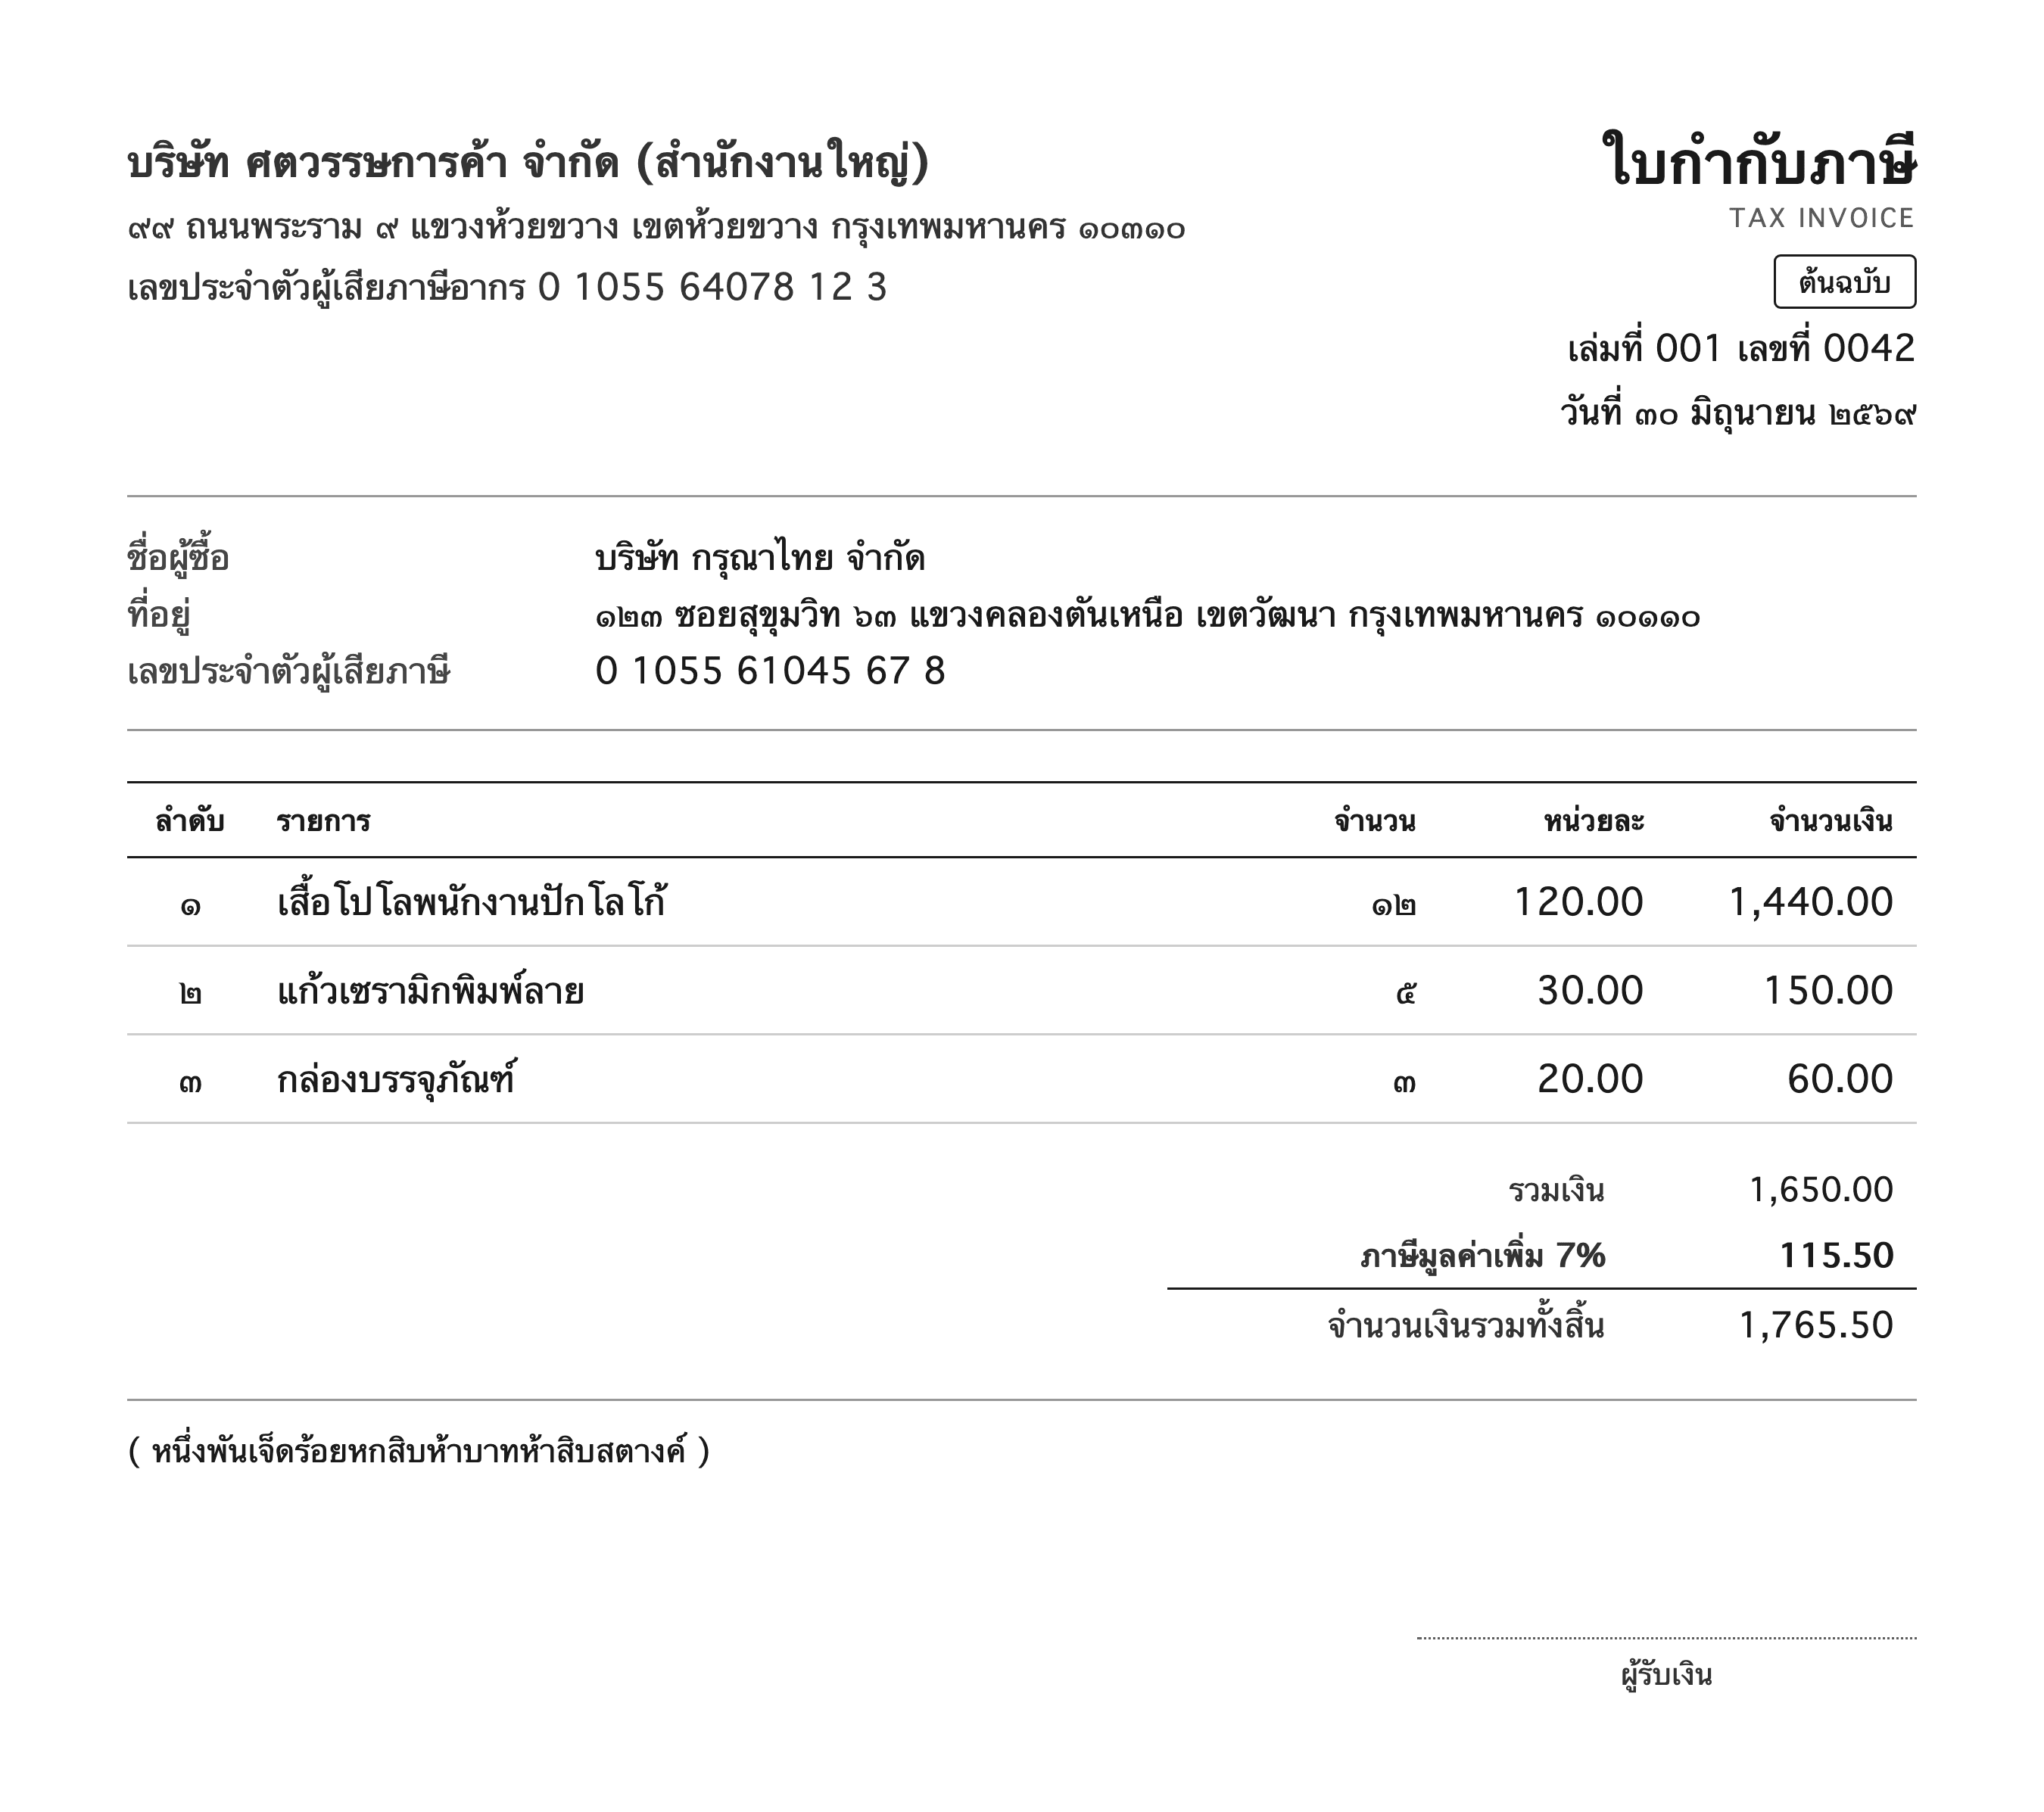
一张填好的税务发票#
上方的样张,就是 OCR 页面发布的那张泰国税务发票。下面是模型针对税务发票 schema 给出的原始响应,只采集一次,未做任何修改。每一行依次是 schema 命名的一个字段、为它读出的值,以及读取过程对这个值能确认什么。
seller
- nameบริษัท ศตวรรษการค้า จำกัด读自印刷文字
- tax_id0105564078127读自印刷文字
印刷原文:0 1055 64078 12 7
- address๙๙ ถนนพระราม ๙ แขวงห้วยขวาง เขตห้วยขวาง กรุงเทพมหานคร ๑๐๓๑๐读自印刷文字
buyer
- nameบริษัท กรุณาไทย จำกัด读自印刷文字
- tax_id0105561045678读自印刷文字
印刷原文:0 1055 61045 67 8
- address๑๒๓ ซอยสุขุมวิท ๖๓ แขวงคลองตันเหนือ เขตวัฒนา กรุงเทพมหานคร ๑๐๑๑๐读自印刷文字
- book_number001读自印刷文字
- invoice_number0042读自印刷文字
- issue_date2026-06-30读自印刷文字
印刷原文:๓๐ มิถุนายน ๒๕๖๙
items[0]
- descriptionเสื้อโปโลพนักงานปักโลโก้读自印刷文字
- quantity12读自印刷文字
印刷原文:๑๒
- unit_price120读自印刷文字
印刷原文:120.00
- amount1440读自印刷文字
印刷原文:1,440.00
items[1]
- descriptionแก้วเซรามิกพิมพ์ลาย读自印刷文字
- quantity5读自印刷文字
印刷原文:๕
- unit_price30读自印刷文字
印刷原文:30.00
- amount150读自印刷文字
印刷原文:150.00
items[2]
- descriptionกล่องบรรจุภัณฑ์读自印刷文字
- quantity3读自印刷文字
印刷原文:๓
- unit_price20读自印刷文字
印刷原文:20.00
- amount60读自印刷文字
印刷原文:60.00
- subtotal1650读自印刷文字
印刷原文:1,650.00
- vat115.5读自印刷文字
印刷原文:115.50
- total1765.5读自印刷文字
印刷原文:1,765.50
- total_in_words1765.5读自印刷文字
印刷原文:หนึ่งพันเจ็ดร้อยหกสิบห้าบาทห้าสิบสตางค์
paxa-doc-extract-v1 · 记录于 2026年9月12日 · 未经编辑
印刷原文与交付的值不同时,原文显示在值的下方。地址中的泰文数字按印刷原样保留,税号则从分格书写的数字框中读成一个字符串。
一个值凭什么留下#
三条规则决定每一个字段。正是这三条规则,让结果成为记账系统可以直接据以处理的东西。
值要么读自印刷文字,要么为 null。
每个值都是模型在页面上指出的一段文字,再在这里按其类型读取。没有印出来的数字、日期或名称,都不会出现在结果中。唯一的例外是由您列出选项的分类,例如文档种类。那一项是在您给定的值中做选择。
校验失败会说明原因。
校验位错误的十三位号码,低于您所设下限的金额,您声明不能是未来却落在未来的日期。每一种都返回 null,并附上固定的原因。如果您提出要求,它所依据的印刷原文也会一并返回。原因是一个封闭的列表,流程可以据此分支处理。
必填字段决定结果是否完整。
您标出文档必须载有的字段。这些字段全部有值时,结果为完整,否则为不完整。如果文件是另一种文档,结果会以不完整返回,大多数必填字段缺失。识别出错误的文档,依据的是页面上实际找到的内容。
懂泰国文档的类型#
除了字符串、数字、日期和您自定义的取值列表,schema 还为泰国文书以自己方式印出的内容提供了专门的类型。
十三位识别号
身份证号、法人登记号和税号,可从分格书写的数字或泰文数字读成十三位数字,并验证校验位。读错一位就无法通过校验。该字段返回 null,若开启了证据,印刷的数字会一并返回。看似正确的错误号码,就在这里被拦下。
佛历日期
日在前,月份可以是数字,也可以是印出来的泰文、英文或其他语言的名称,年份用哪种纪年都可以。两位数年份会被解析到让日期落在不久之前的那个纪年。每一次这样的解析都会在响应中列出,并附上印刷的原始数字。您可以据此推翻它。
文字书写的金额
泰国收据会把合计金额用文字再写一遍,这里把它读成数字,萨当(satang)也包括在内。同一笔合计有数字和文字两种独立读法,这是收据能提供的最有力的校验。
府
全部 77 个府,可从全称、缩写或代码匹配,并按您要求的形式交付:泰文名称、英文名称或代码。
银行与保险公司
泰国的每一家银行和每一家持牌保险公司,按文档实际印出的各种写法匹配,包括曾用名。可交付为简称、代码或全称。
法律组织形式
บจก.、บมจ.、หจก.、ร้าน 等,无论文档用的是缩写还是全称,是泰文还是英文,都能匹配。
已备好 schema 的文档#
工具中为三种泰国文档提供了现成的 schema。下面每个页面逐个字段介绍文档本身,以及读取这种文档时必须读对的地方。
常见问题,如实作答#
它能读取哪些种类的文档?
任何您能为之编写 schema 的文档,PDF 或图片均可。这里的样张是税务发票,收据、预扣税证明、表单和对账单走的是同一条路径。schema 说明每个字段的含义,字段只会用确实是该内容的那段文字来填。
schema 怎么写?
写成一组有名称的字段,每个字段有一个类型,还可以加一行供模型阅读的说明。对象用来给字段分组,数组用来容纳明细行这类重复的行。字段提取工具一开始就为您备好三个现成的 schema,API 文档列出了每种类型及其可用的键。
每个字段有置信度分数吗?
不返回分数。一位读错的数字被如实照抄后,在任何分数看来都很确定,看不见这种错误的数字只会误导人。返回的是另外三件事:每个值是否读自印刷文字,是否通过了其类型自带的校验,以及必填字段是否齐全。
如果文档不是 schema 预期的那种,会怎样?
结果会以不完整返回,大多数必填字段列为缺失。这就是把它转到别处处理的信号。这次请求照常计费,因为页面已被完整读取。
能看到每个值来自哪里吗?
可以。请求证据后,响应会把每个字段对应到它所读取的那段印刷文字,无论能否从中读出值。请求读取文本后,页面文字也会一并返回,与 OCR 接口返回的读取结果相同。
它能读泰文数字吗?
凡是预期为数字、日期或识别号的位置,泰文数字都会读成数字,在文本字段里则按印刷原样保留。无法按其类型读取的值返回 null。系统不做任何猜测。
费用多少,怎么开始?
按页计费,费率见价格页面。每个新账户都附带免费积分,无需绑卡。打开字段提取工具,选一个 schema,放入一份文档即可。