PDF 转 JSON,按您定义的结构返回
一张发票,一份 Schema#
OCR 页面上的税务发票样本、读取它所用的 Schema,以及 API 返回的字段。字段是实际调用时记录的响应,没有任何修改。
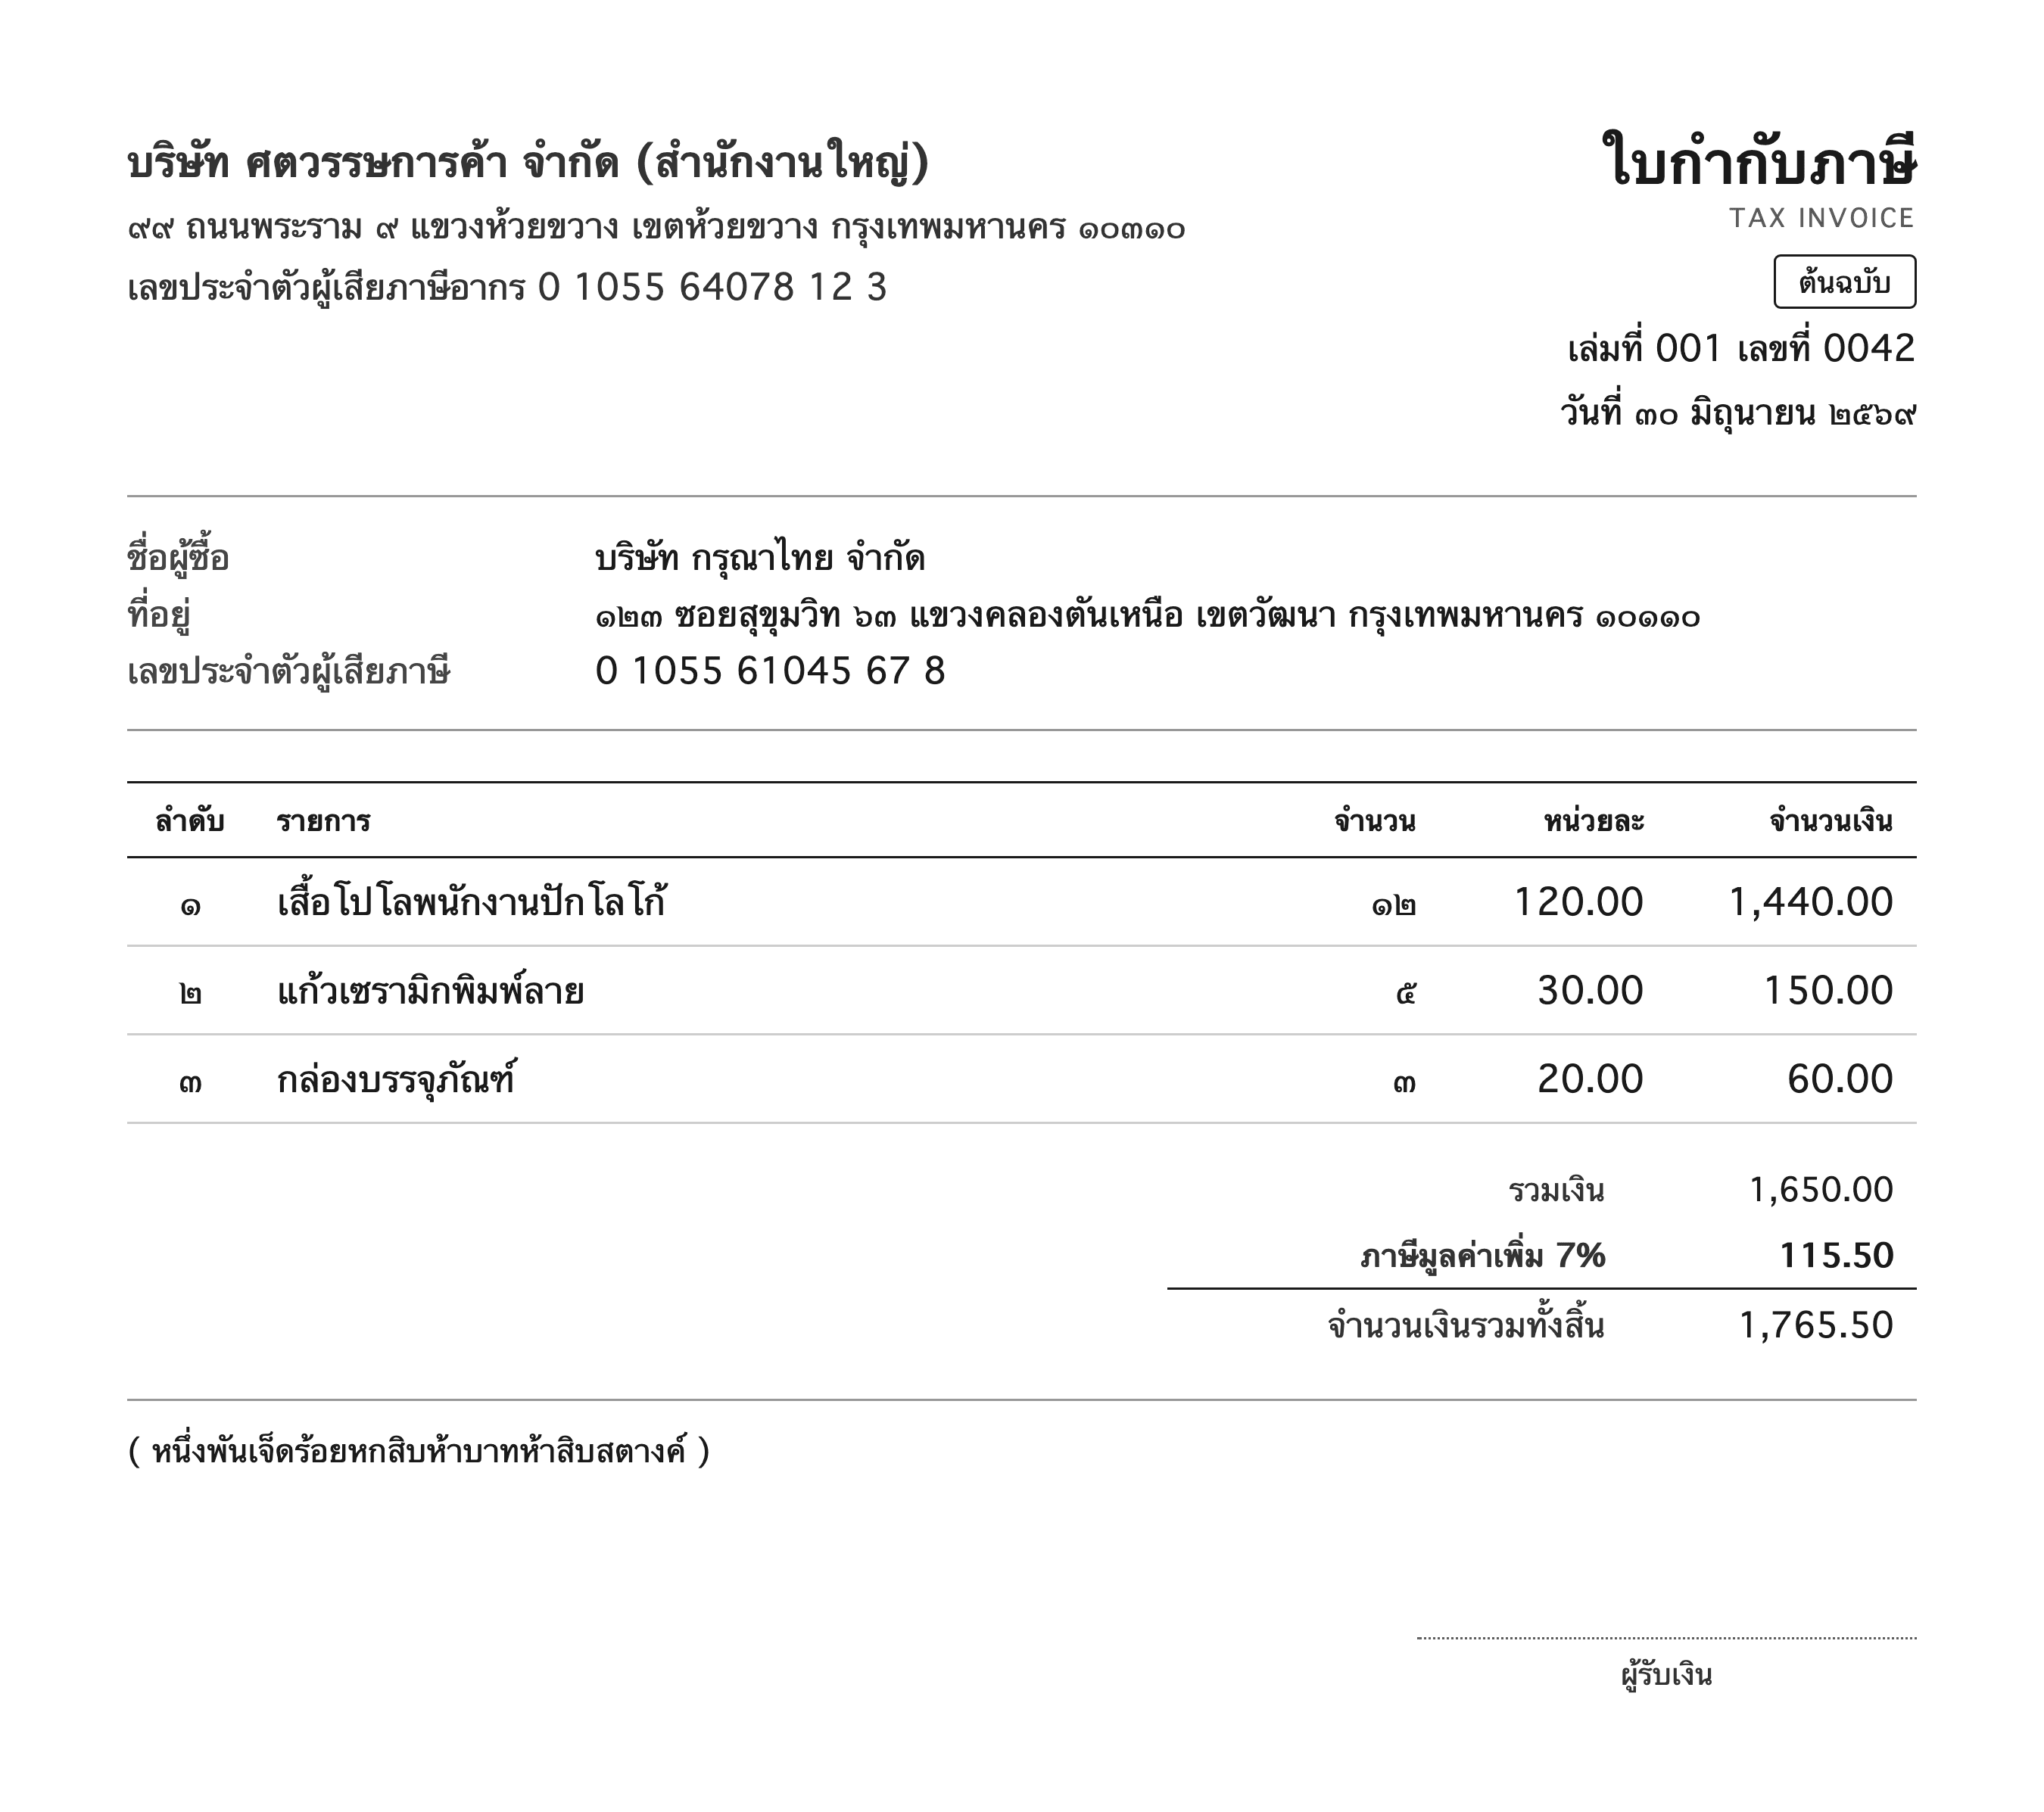
一页泰语税务发票,排版制作的样本,以 PNG 文件发送。
{
  "seller": {
    "name": "บริษัท ศตวรรษการค้า จำกัด",
    "tax_id": "0105564078127",
    "address": "๙๙ ถนนพระราม ๙ แขวงห้วยขวาง เขตห้วยขวาง กรุงเทพมหานคร ๑๐๓๑๐"
  },
  "buyer": {
    "name": "บริษัท กรุณาไทย จำกัด",
    "tax_id": "0105561045678",
    "address": "๑๒๓ ซอยสุขุมวิท ๖๓ แขวงคลองตันเหนือ เขตวัฒนา กรุงเทพมหานคร ๑๐๑๑๐"
  },
  "book_number": "001",
  "invoice_number": "0042",
  "issue_date": "2026-06-30",
  "items": [
    {
      "description": "เสื้อโปโลพนักงานปักโลโก้",
      "quantity": 12,
      "unit_price": 120,
      "amount": 1440
    },
    {
      "description": "แก้วเซรามิกพิมพ์ลาย",
      "quantity": 5,
      "unit_price": 30,
      "amount": 150
    },
    {
      "description": "กล่องบรรจุภัณฑ์",
      "quantity": 3,
      "unit_price": 20,
      "amount": 60
    }
  ],
  "subtotal": 1650,
  "vat": 115.5,
  "total": 1765.5,
  "total_in_words": 1765.5
}
{
  "fields": {
    "seller": {
      "type": "object",
      "fields": {
        "name": {
          "type": "string",
          "required": true
        },
        "tax_id": {
          "type": "thai_id",
          "required": true
        },
        "address": {
          "type": "string"
        }
      }
    },
    "buyer": {
      "type": "object",
      "fields": {
        "name": {
          "type": "string",
          "required": true
        },
        "tax_id": {
          "type": "thai_id"
        },
        "address": {
          "type": "string"
        }
      }
    },
    "book_number": {
      "type": "string"
    },
    "invoice_number": {
      "type": "string",
      "required": true
    },
    "issue_date": {
      "type": "date",
      "required": true
    },
    "items": {
      "type": "array",
      "max_items": 9,
      "items": {
        "type": "object",
        "fields": {
          "description": {
            "type": "string",
            "required": true
          },
          "quantity": {
            "type": "number"
          },
          "unit_price": {
            "type": "number"
          },
          "amount": {
            "type": "number",
            "required": true
          }
        }
      }
    },
    "subtotal": {
      "type": "number"
    },
    "vat": {
      "type": "number",
      "required": true
    },
    "total": {
      "type": "number",
      "required": true
    },
    "total_in_words": {
      "type": "amount_words"
    }
  }
}
paxa-doc-extract-v1 · 记录于 2026年9月12日
从文件到 JSON#
每份文档一次请求,填好的字段直接随响应返回,无需轮询任务状态。
编写 Schema
为每个字段命名并指定类型,例如 string、number、date,或 thai_id、amount_words 这类面向泰国文档的类型。把每份文档都必须具备的字段标为 required。
发送文件
以 base64 POST 到 /v1/extract 并附上 Schema,支持 PDF、PNG、JPEG 和 WebP,最多 20 页、10 MiB。
读取字段
字段按 Schema 的结构返回,所有 required 字段都有值时 status 为 complete。把 include_evidence 设为 true,每个值都会附上它所读取的印刷原文。
Paxa Document Extraction 标价为每千页 $13,适用于不超过 50 个字段的 Schema,超过时为每千页 $20。
常见问题#
支持哪些文件?
PDF、PNG、JPEG 和 WebP,每次请求最多 20 页、10 MiB。每次请求发送一份文档,包含多份文档的文件只返回一组字段。
Schema 可以多大?
最多 100 个叶字段,序列化为 JSON 后不超过 128 KB。数组中的叶字段按 max_items 允许的元素数重复计数。
页面上没有某个值时会怎样?
该字段返回 null。为 null 的 required 字段会列入 missing,并使 status 变为 incomplete。印刷值未通过类型校验时,例如校验位不符,该字段为 null,原因列在 unverified 中。
有哪些面向泰国文档的字段类型?
thai_id 读取 13 位识别号码并核对校验位。date 按日在前的习惯读取日期,佛历和公历都能识别。amount_words 读取用文字书写的金额,province、bank 和 insurer 则与内置列表匹配。
从免费积分开始
使用 Google、GitHub 或 Hugging Face 登录,即可用 100 一次性免费积分处理您自己的文本。