图片转文字,适用于照片、截图和扫描件
一张收据,从图片读出#
左边是一张以单张图片发送的泰语收据样本,右边是模型返回的文字。输出是实际调用时记录的响应,没有任何修改。
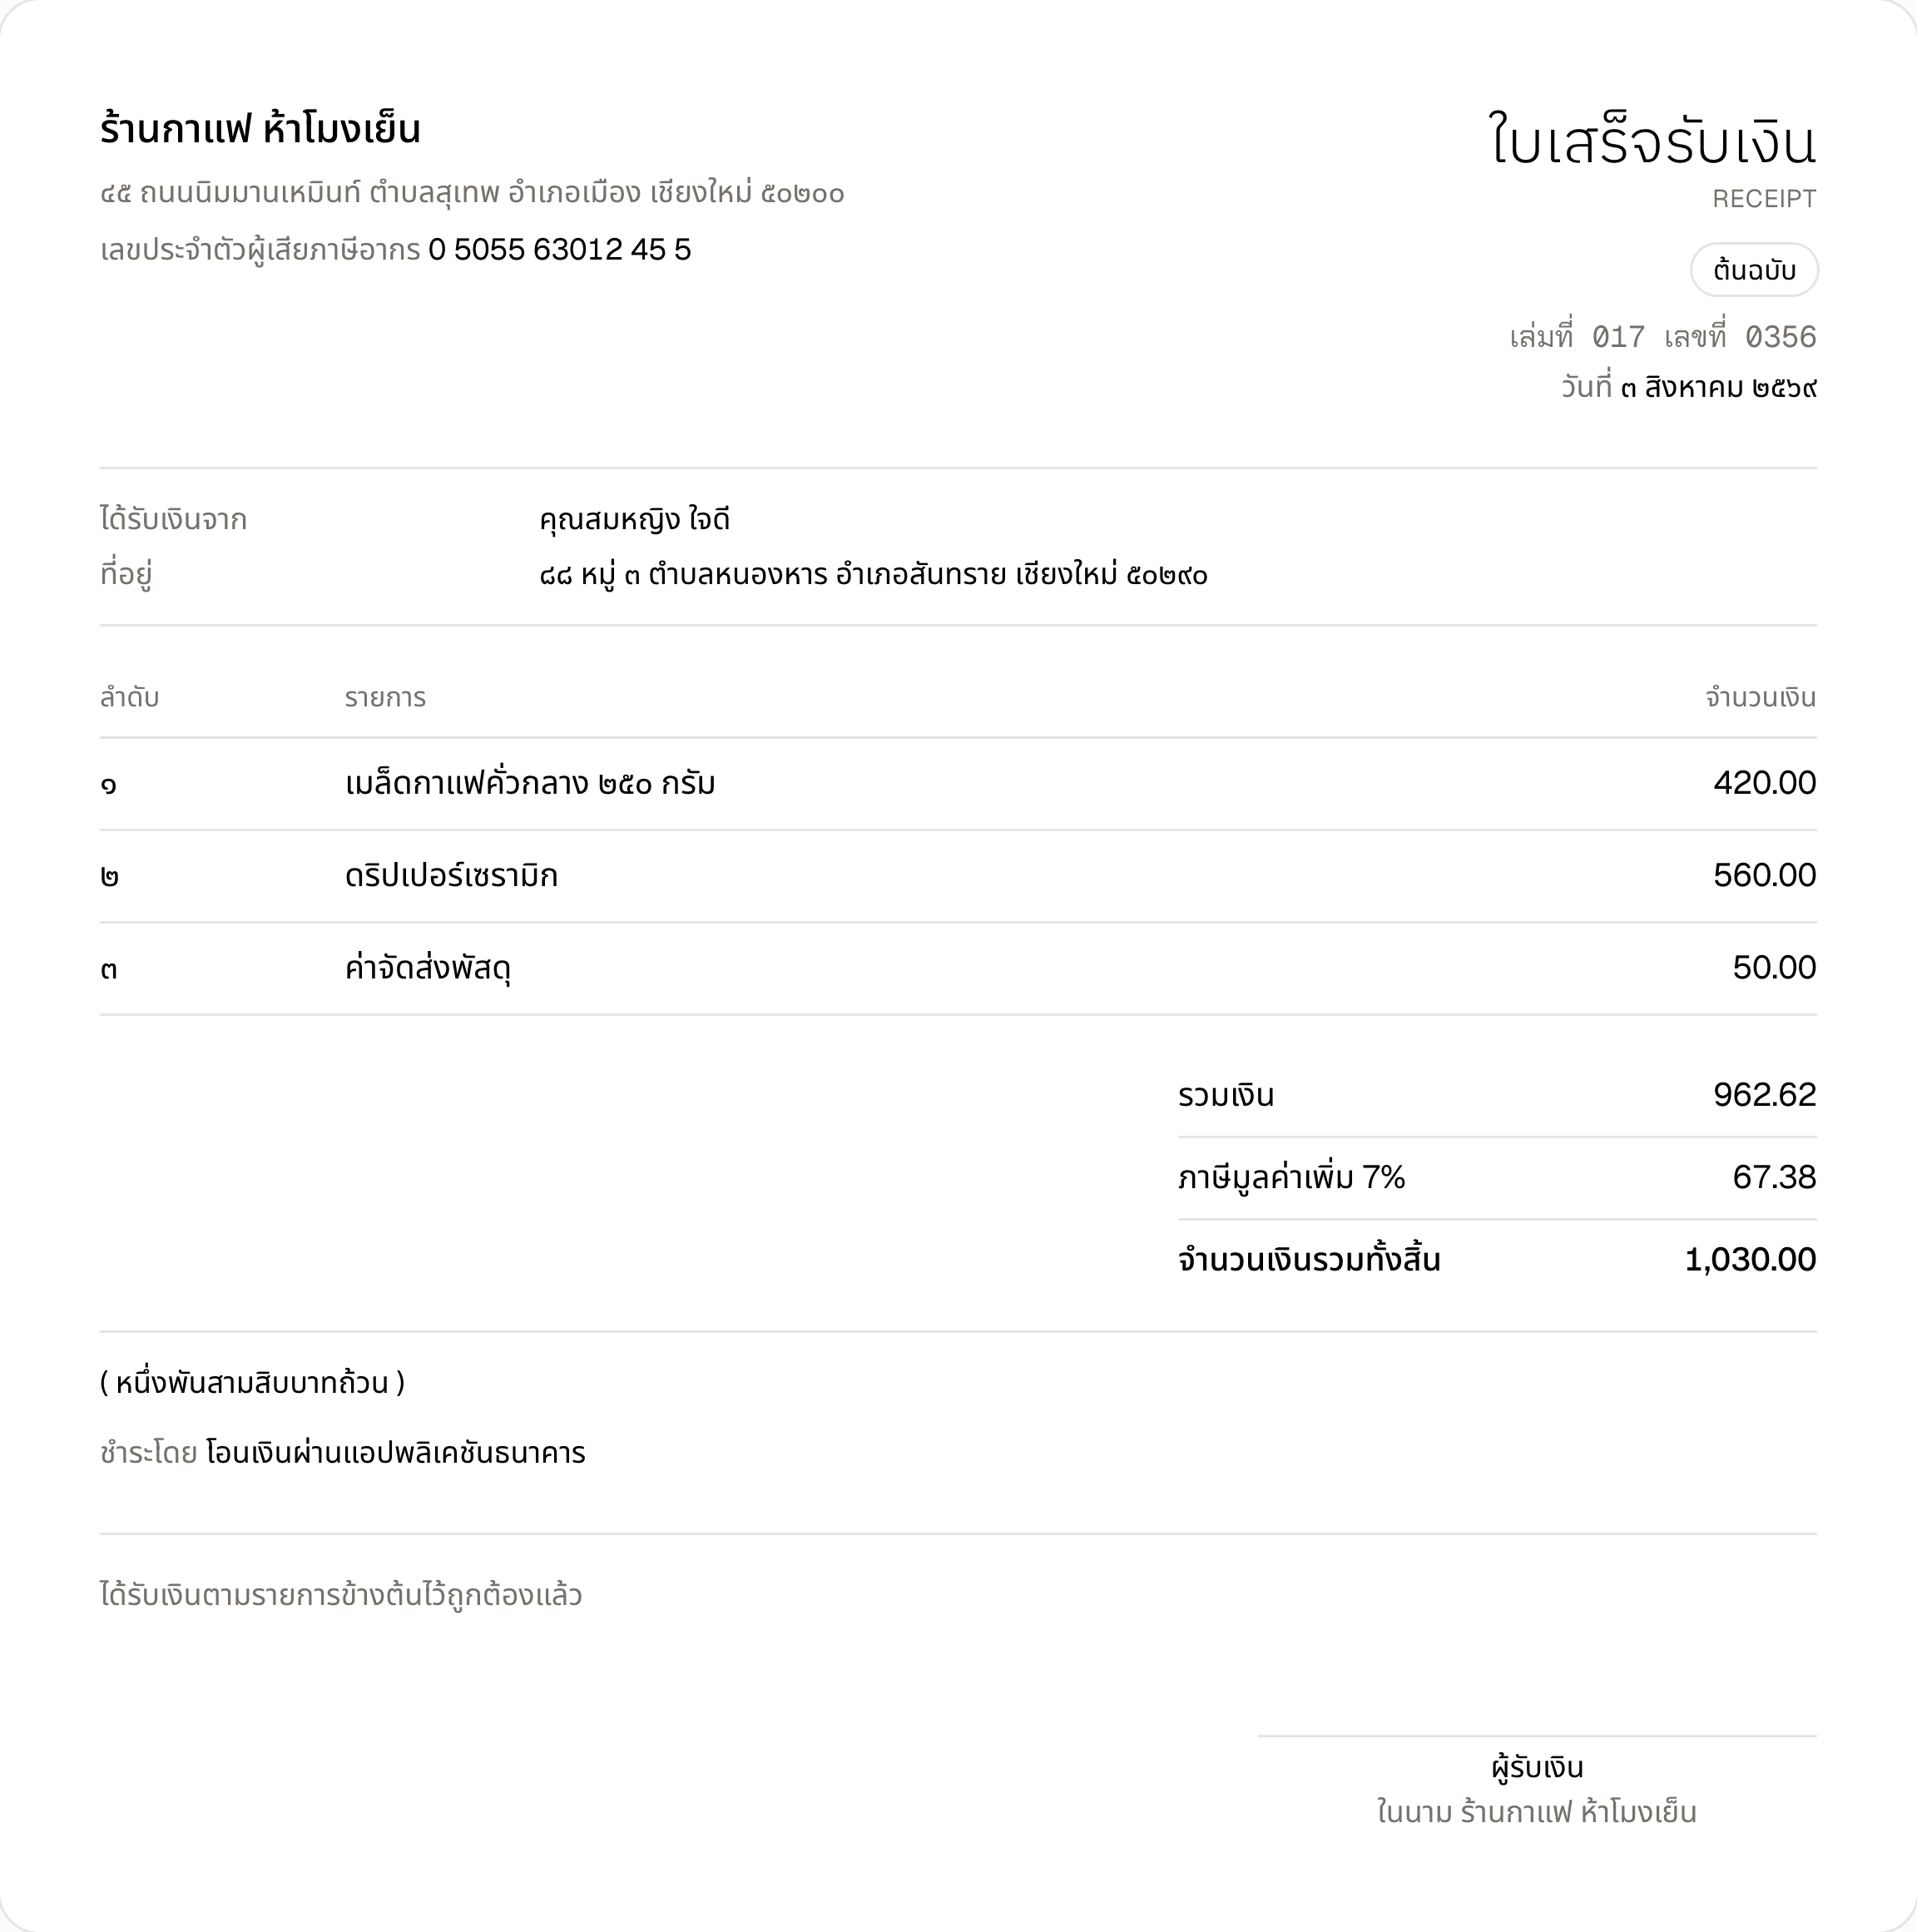
一页泰语收据,排版为样本后以 PNG 发送。
# ร้านกาแฟ ห้าโมงเย็น

๕๕ ถนนนิมมานเหมินท์ ตำบลสุเทพ อำเภอเมือง เชียงใหม่ ๕๐๒๐๐

เลขประจำตัวผู้เสียภาษีอากร 0 5055 63012 45 5

# ใบเสร็จรับเงิน
RECEIPT

ต้นฉบับ

เล่มที่ 017 เลขที่ 0356

วันที่ ๓ สิงหาคม ๒๕๖๙

| | |
| :--- | :--- |
| ได้รับเงินจาก | คุณสมหญิง ใจดี |
| ที่อยู่ | ๘๘ หมู่ ๓ ตำบลหนองหาร อำเภอสันทราย เชียงใหม่ ๕๐๒๙๐ |

| ลำดับ | รายการ | จำนวนเงิน |
| :--- | :--- | :--- |
| ๑ | เมล็ดกาแฟคั่วกลาง ๒๕๐ กรัม | 420.00 |
| ๒ | ดริปเปอร์เซรามิก | 560.00 |
| ๓ | ค่าจัดส่งพัสดุ | 50.00 |

| | |
| :--- | :--- |
| รวมเงิน | 962.62 |
| ภาษีมูลค่าเพิ่ม 7% | 67.38 |
| จำนวนเงินรวมทั้งสิ้น | 1,030.00 |

( หนึ่งพันสามสิบบาทถ้วน )

ชำระโดย โอนเงินผ่านแอปพลิเคชันธนาคาร

ได้รับเงินตามรายการข้างต้นไว้ถูกต้องแล้ว

ผู้รับเงิน
ในนาม ร้านกาแฟ ห้าโมงเย็น
[
  {"type":"heading","level":1,"text":"ร้านกาแฟ ห้าโมงเย็น"},
  {"type":"paragraph","text":"๕๕ ถนนนิมมานเหมินท์ ตำบลสุเทพ อำเภอเมือง เชียงใหม่ ๕๐๒๐๐"},
  {"type":"paragraph","text":"เลขประจำตัวผู้เสียภาษีอากร 0 5055 63012 45 5"},
  {"type":"heading","level":1,"text":"ใบเสร็จรับเงิน"},
  {"type":"paragraph","text":"RECEIPT"},
  {"type":"paragraph","text":"ต้นฉบับ"},
  {"type":"paragraph","text":"เล่มที่ 017 เลขที่ 0356"},
  {"type":"paragraph","text":"วันที่ ๓ สิงหาคม ๒๕๖๙"},
  {"type":"paragraph","text":"ได้รับเงินจาก คุณสมหญิง ใจดี"},
  {"type":"paragraph","text":"ที่อยู่ ๘๘ หมู่ ๓ ตำบลหนองหาร อำเภอสันทราย เชียงใหม่ ๕๐๒๙๐"},
  {"type":"table","rows":[["ลำดับ","รายการ","จำนวนเงิน"],["๑","เมล็ดกาแฟคั่วกลาง ๒๕๐ กรัม","420.00"],["๒","ดริปเปอร์เซรามิก","560.00"],["๓","ค่าจัดส่งพัสดุ","50.00"]]},
  {"type":"table","rows":[["รวมเงิน","962.62"],["ภาษีมูลค่าเพิ่ม 7%","67.38"],["จำนวนเงินรวมทั้งสิ้น","1,030.00"]]},
  {"type":"paragraph","text":"( หนึ่งพันสามสิบบาทถ้วน )"},
  {"type":"paragraph","text":"ชำระโดย โอนเงินผ่านแอปพลิเคชันธนาคาร"},
  {"type":"paragraph","text":"ได้รับเงินตามรายการข้างต้นไว้ถูกต้องแล้ว"},
  {"type":"paragraph","text":"ผู้รับเงิน"},
  {"type":"paragraph","text":"ในนาม ร้านกาแฟ ห้าโมงเย็น"}
]
paxa-ocr-lite-v1 · 记录于 2026年9月12日
从图片到文字#
控制台里的“文档识别”工具可以在浏览器中完成这一步,同样的读取也可以用一次 API 请求完成。
添加图片
把 PNG、JPEG 或 WebP 拖进“文档识别”工具,也可以用最多 50 页的 PDF。单个文件最大 10 MiB。
开始读取
文字以 Markdown 返回,每页一段。图片里的表格仍以表格返回,每一行都保留自己的单元格。
复制或导出
把文字复制到文档里,或者选择 structured 形式,标题、段落、列表和表格会成为各自带类型的区块。
Paxa OCR Lite 标价为每千页 $6.50。新账户的免费积分可以完成第一次读取,无需绑卡。所有套餐见价格页。
常见问题#
怎么把图片转成文字?
打开“文档识别”工具,添加图片,然后读取。文字会显示在图片旁边,一键即可复制。支持 PNG、JPEG、WebP 和 PDF,文件最大 10 MiB。
能从图片里读出哪些语言?
简体中文、英语、泰语和其他语言都能读,包括多种语言混排的图片,例如带英文品名的中文单据。无需事先选择语言。
表格会保留吗?
会。图片里的表格以 Markdown 表格返回;在 structured 形式中,表格是一个区块,行以单元格数组的形式保存。
截图和手机拍的照片能读吗?
能。两者都是图片,读取方式与扫描件相同。正对拍摄、光线均匀的照片能给模型最多的信息。
如何只取出总金额或日期这样的字段?
对同一个文件使用 Document Extraction。写下想要的字段名,即可取回填好的字段,每个值都附带它在文档中对应的印刷原文。
有 API 吗?
有。OCR 页面介绍了请求方式,PDF 转 Markdown 展示了响应的形式。
从免费积分开始
使用 Google、GitHub 或 Hugging Face 登录,即可用 100 一次性免费积分处理您自己的文本。